Социализируемся

Я в Google+ Я в Twitter Я в Facebook

Showing posts with label Семантическая разметка. Show all posts

Friday, January 18, 2013

Is Google Hijacking Semantic Markup/Structured Data?

    На заметку
Интересная статья - анализ с предысторией стратегия Google на пути к Semantic Web

Is Google Hijacking Semantic Markup/Structured Data?

Jan 17, 2013 at 3:54pm ET by Barbara Starr,
http://searchengineland.com

Friday, June 24, 2011

Microdata4Google

На пути к Semantic Web. Microdata.
(Также полезно для SEO, семантическое ядро сайта, семантическая разметка сайта)

Одним из важных шагов к достижению Семантического Веба (Semantic Web) с времен разработки RDF, стало создание лидерами поисковой индустрии Google, Bing и Yahoo! ресурса schema.org. Schema.org является вендорной спецификацией набора из около 300 мини-схем (или структурированных мета-данных), которые можно использовать для разметки (тегирования) информации, представленной на веб-страницах. Эти схемы организованы в небольшую стройную иерархию и покрывают (охватывают) множество популярных предметных областей (ПрО) – от представления организаций, отдельных людей и до продуктов, товаров и творческой деятельности – то, про что можно написать и охарактеризовать и опубликовать в вебе.

Эти спецификации схем данных основаны на стандартах микроданных (microdata), входящих в состав спецификации HTML5. Микроданные – это набор записей, содержащих описания, представленных парами ключ-значение (тег-значение), который можно включать (внедрять) (embedded) в html-код веб-страницы. Эти схемы микроданных подобны микроформатам, однако они шире в покрытии тем и более расширяемы. Помимо этого, микроданные проще, чем RDFa – другой спецификации W3C, которую организаторы schema.org называют “… расширяемым и очень выразительным, но значительная сложность языка является причиной медленного принятия общественностью».

(Про микроформаты и микроданные, инструментарий от Яндекса, Гугла и т.п.)

Появление микроданных вызвало большую бурю в научном сообществе о том, что эта инициатива нивелирует труд десятилетий по развитию и популяризации RDF и RDFa. На наш взгляд, эта инициатива не является отказом от RDF, а есть логичное развитие идей семантического веба с учетом развития, достижений и изменения уровня понимания проблемы и накопленных знаний.

RDF и его модель представления данных тройками есть простейший и наиболее выразительный способ представления любых данных и связей между данными. Поэтому, RDF и его развития, такие как OWL и онтологии, предоставляет ясную и гибкую каноническую модель данных для представления существующих данных или схем данных. Вне зависимости от исходной формы исходной информации, ее можно разбить, выделить и представить в формате RDF, а также связать с любой другой информацией. Поэтому часто RDF называют универсальным языком представления данных.

Однако зачастую простейшие данные не нуждаются в сложности RDF. Научное сообщество W3C не раз аргументированно заявляло о важности „наивных” структур представления данных. Большинство из таких типов представляют собой простые пары ключ-значение, а объект высказывания предполагается. К этому типу относятся и структурированные записи в Википедии, называемые инфобоксами (infoboxes). Также простые форматы данных имеют JSON и много других простейших форматов данных.

Основным является утверждение, что RDF предоставляет универсальную модель данных для любого вида данных, а также средство обмена данными. Получившие распространение форматы обмена данными, в отличие от RDF, легко понимаемы, легко выразимы и, следовательно, получили широкое применение. Заявка про использование микроданных лидерами поисковых систем веба означает реальное изменение в возможностях  и выразительности структурированных данных, представленных в вебе. Количество структурированной информации резко возрастет.

Чем больше появляется структурированной информации, тем больше получает распространение, внимание и развитие применение RDF, который, с наступлением своего времени, будет использоваться повсеместно для взаимодействия с этими данными. Скоро должны появиться множество утилит, инструментов и сервисов, позволяющих автоматически добавлять такие структуры (структурированные данные) к веб-страницам с помощью одного клика. 

Google все больше внимания уделяет структурированным данным. С каждым днем все больше структурированных данных появляется в результатах выдачи Google; компания запустила очень активную программу по извлечению структурированных данных из текстовых данных и таблиц. Google видит, что поисковые потребности постепенно отходят от поиска по ключевм словам к структурам, взаимосвязям, а также фильтрации и таргетировании результатов. Эти преимущества и возможности вытекают из структур, так же как и семантические взаимосвязи между сущностями.

Многие задаются вопросом, почему Google проталкивает микроданные, а не микроформаты или RDFa или более ранние их варианты. Конечно, Google имеет коммерческие интересы в расширении и увеличении полезности веба. Заявив об использовании микроданных, которые проще в понимании и использовании рядовыми пользователями, поисковые магнаты способствуют ускорению публикации таких данных в вебе, генерированию таких данных и т.п. В дальнейшем, когда придет время и количество опубликованных структурированных данных достигнет необходимого количества (т.е. Структурированный веб начнет становиться семантическим), эти монстры откажутся от них и перейдут к более универсальному, гибкому и продуманному RDF. 
Модель данных заявленных микроданных достаточно общая и получена из RDF Schema (которая в свою очередь получена из Cycl) (Data Model, http://www.schema.org/docs/datamodel.html).

Она содержит:
    1. набор типов, организованных в иерархию множественного наследования, где каждый тип может быть подклассом множества классов.
    2. набор свойств, где:
-         - каждое свойство может иметь одно или более типов в качестве доменов (domain). Свойство может использоваться для экземпляров любого из этих типов.
-         - каждое свойство может иметь одно или более типов в качестве диапазонов (range). Значение/я свойства должны быть экземплярами как минимум одного из этих типов.

Выбор решения разрешить использовать множественные домены и диапазоны носит чисто прагматический характер. Поскольку вычислительные свойства систем с одним доменов и диапазоном проще в понимании, на практике, это будет способствовать созданию множества искуственных типов, которые могут быть использованы напрямую как домены или диапазоны некоторых свойств.

Микроданные, по заявлению авторов, имеют отображение на RDFa – RDFa версии 1.1 разметки «почти» изоморфно версии микроданных. Схема микроданных имеет описание в OWL-формате.

Иерархия типов, представленная на сайте, как заявляют авторы, не направлена стать глобальной онтологией мира. Она только охватывает типы сущностей, которые по мнению организаторов (Microsoft, Yahoo! и Google) могут представлять интерес и быть обработанными их поисковыми системами в ближайшем будущем.

Основным девизом этого начинания, можно сказать, является фраза с сайта schema.org:
In the spirit of "some data is better than none", we will accept this markup and do the best we can.

Имхо, судя по всему, заявление о поддержке микроданных и появлении schema.org является отправной вехой на пути к Semantic Web.
По материалам сайта schema.org и обсуждений научного сообщества Semantic Web.     

Tuesday, December 21, 2010

Семантическая разметка. Инструменты. Микроформаты в жизни.

Яндекс.Вебмастер представил валидатор микроразметки

2010-12-20 12:27

Яндекс.Вебмастер сообщил о появлении нового инструмента – валидатора микроразметки, предназначенного для того, чтобы облегчить владельцам сайтов работу с разметкой страниц микроформатами. С помощью нового инструмента можно проверить, как поисковый робот Яндекса видит и обрабатывает семантическую разметку той или иной страницы, а также выяснить, есть ли в коде разметки ошибки, которые могут помешать корректной обработке данных.

Микроформаты – это стандарт семантической разметки, разработанный специально для структурирования информации на странице для программ-обработчиков. Микроформаты позволяют указать поисковому роботу на смысловое значение отдельных фрагментов страницы и используются для передачи сведений об организации, товарах, отзывах, рецептах.

Сейчас Яндекс поддерживает четыре вида микроформатов:

  •  hCard - формат разметки контактной информации (адресов, телефонов и т.д. Довольно старый и хорошо зарекомендовавший себя стандарт. Входит в состав рекомендованных к использованию консорциумом W3C для Semantic Web. Полезен для указания на странице контактной информации о фирме и т.п.

  •  hRecipe - формат для описания кулинарных рецептов. Стандарт довольно новый. Используется очень редко (по моим наблюдениям ИМХО). В состав рекомендованных к использованию консорциумом W3C для Semantic Web не входит, хотя стандарты, пополняющие список рекомендаций консорциума, становятся стандартами "де факто". Поэтому при определенной популярности он таковым может стать. Гугл его поддерживает, но для рецептов он также поддерживает еще ряд стандартов.


Также поддерживается microdata – международный стандарт семантической разметки, позволяющий с помощью атрибутов описать смысл информации, содержащейся в HTML-коде страниц. Такие атрибуты позволяют роботам-обработчикам находить и извлекать нужные данные. Про этот стандарт слышу впервые...Погуглив немного выясняем - микроданные как стандарт де-юре еще не приняты - на сайте консорциума W3C есть документ от 19 октября 2010 года - Рабочий проект HTML Microdata, поэтому мной ранее не рассматривались. Будет принят по всей видимости "де-факто".

(Подробнее про микроданные для Google-Yahoo!-Bing июнь 2011.)

В настоящий момент в Яндексе микроданные используются для разметки словарных и энциклопедических статей, терминов и определений.

Подробнее узнать о том, какие данные можно передать Яндексу, можно на странице «Передача данных о содержимом сайта». А о микроформатах и микроданных можно прочесть в разделе Помощи.

Ссылка про все микроформаты (eng).

По этому поводу следует заметить, что Google уже давно поддерживает микроформаты, а также семантическую разметку RDFa, и по своему движению более приближен к общей тенденции Semantic Web. Рано или поздно Яндекс перейдет на поддержку и RDFa. Подробнее об использовании микроформатов для индексатора Гугл можно прочитать в его справке, а проверить страницы можно при помощи Google Web Master Tools. Список микроформатов, используемых роботами Google несколько отличается от Яндекса и более широк.

Проблема же заключается в том, что когда сайт создается "ручками", внедрить микроформаты просто, однако очень трудоемко. На сегодняшний день пока нет инструментария для автоматизированного добавления микроформатов в текст html-кода. Вторая проблема - большинство веб-разработчиков пользуется CMS, что естественно облегчает работу, однако не позволяет работать с html-кодом, либо внедрение микроформатов еще более усложняется. Поэтому большинство разработчиков с микроформатами "не заморачивается".

О пользе использования микроформатов и RDF говорить не приходится - используя их уже лет семь-восемь, могу сказать, что сайт и раскручивается быстрее, и повышается релевантность поиска, позиционирование его в результатах.

Стоит также дополнить список микроформатов, которые следует использовать веб-мастерам для улучшения позиционирования и распознавания поисковыми роботами своего сайта (в свете движения к Semantic Web):
  • - основа основ - стандарт Dublin Core
  • - очень широко используемый стандарт Topic Maps (XMT) – стандарт ISO (ISO/IEC 13250:2003) для представления и обмена знаниями с точки зрения поиска информации
  • vCard - аналог hCard
  • - формат FOAF - информация о людях и их "дружественных отношениях".
  • - ну и главный формат описания ресурсов - RDF - RDFa. Надо добавить, что поддержка RDFa включена в стандарт HTML5

Подробнее про общий принцип построения Semantic Web и увидеть более полный перечень микроформатов можно в разделе 5. Метаданные в статье "SEMANTIC WEB КАК НОВАЯ МОДЕЛЬ ИНФОРМАЦИОННОГО ПРОСТРАНСТВА ИНТЕРНЕТ" (см. в Разделе "Публикации" блога за 2008 г.).

За саму новость спасибо сайту searchengines.ru   Дополнения-размышлизмы мои :).

Даешь RDF в массы! Автоматизацию семантической разметки - в каждый компьютер! Все дружно на построение светлого Semantic Web будущего! :))


Wednesday, November 3, 2010

SW-applications-5

РАЗРАБОТКА РАСПРЕДЕЛЕННЫХ СЕМАНТИЧЕСКИХ ПРИЛОЖЕНИЙ КАК СТРАТЕГИЯ РАЗВИТИЯ СОВРЕМЕННОГО WEB (Продолжение)


Начало


Выводы


Подводя итоги, отметим, что увеличение количества семантических приложений позволит увеличить объемы создаваемой семантически размеченной информации и будет повышать интеллектуальные способности  программных систем. Кроме того, применение компонентов предлагаемого шаблона позволит создать предопределенный набор действий, который позволит семнатическому приложению эффективно решать задачу пользователя.

Список литературы

1.      Barnell A. Building Blocks for Semantic Web Applications. // Доступно на www.w3c.rl.ac.uk/Euroweb/slides/rdfobjects3.ppt
2.      Krötzsch M., Vrande¡ci D., Völkel M. Semantic MediaWiki //The 5th International Semantic Web Conference.- Athens(USA). Доступно на http://korrekt.org/papers/KroetzschVrandecicVoelkel_ISWC2006.pdf
3.      Völkel, M., Krötzsch, M., Vrande¡ci´c, D., Haller, H., Studer, R. Semantic Wikipedia // Proc. of the 15th International WWW Conference. -  Edinburgh(Scotland). -2006.
4.      Krötzsch, M., Vrande¡ci´c, D., Völkel, M. Wikipedia and the Semantic Web, Part II. // Proc. of the 2nd International Wikimedia Conference, Wikimania. - Cambridge (USA). – 2006
Андон Ф.И., Гришанова И.Ю., Резниченко В.А. "Semantic Web как новая модель инормационного пространства интернет", Проблеми програмування. 2008. № 2-3, 417-430.

SW-applications-4

РАЗРАБОТКА РАСПРЕДЕЛЕННЫХ СЕМАНТИЧЕСКИХ ПРИЛОЖЕНИЙ КАК СТРАТЕГИЯ РАЗВИТИЯ СОВРЕМЕННОГО WEB (Продолжение)


Начало    -- 2 --     -- 3 --     4      -- 5 --


Унифицированный шаблон семантического приложения Web

 Web, в отличие от понятия Интернет, представляет собой сеть html-документов, связанных между собой гиперссылками. Семантический веб (Semantic Web) на данный момент представляет собой RDF-документы и базы данных, машинно-обрабатываемые данные, онтологии и подсистемы логического вывода [5]. Вопросы доказательства и доверия пока остаются открытыми.

Semantic Web представляет собой уровень открытой базы данных, надстроенный над вебом (см. Рисунок 1) [4].
Рисунок 1. Semantic Web как уровень открытой базы данных в Web.

Базовые открытые стандарты Semantic Web следующие:

  •      RDF - обеспечивает хранение данных в виде троек;
  •      OWL - определяет системы концептов, называемые онтологиями;
  •      SPARQL - язык запросов к RDF;
  •      SWRL - определяет правила;
  •      GRDDL - предназначен для преобразования данных в формат RDF.
В данном контексте определим понятие "семантическое приложение Web".

Семантическое приложение Web - это приложение, которое работает в соответствии со стандартами Semantic Web, создает и использует "машинно-читаемые" данные и обладает конструктивными особенностями веба, например, работает с распределенными онтологиями и/или данными.


Кроме того, необходимо отметить, что семантическое приложение должно воспринимать открытый мир; это значит, что оно должно знать, что информация никогда не бывает полной.
Во-вторых, приложение должно использовать некоторое формальное описание семантики данных. 


В-третьих, семантическое приложение должно использовать информационные источники, которые:

  •      географически распределены;
  •      имеют разных собственников, и, следовательно, отсутствует контроль за развитием данного источника;
  •      являются гетерогенными (синтаксически, структурно и семантически);
  •      содержат данные реального мира, т.е. источники должны быть относительно большими.
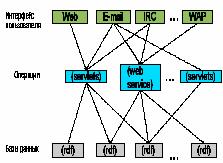
Согласно концепции Semantic Web на самом нижнем уровне семантическому приложению необходимо работать с  наборами RDF-троек, представляющих собой реализацию модели "объект-атрибут-значение" (см. Рисунок 2). Это позволяет обеспечить универсальный промежуточный слой между реальными источниками данных, которые представлены в различных форматах и структурах.


Рисунок 2. Архитектура семантических приложений Semantic Web

Таким образом, семантическое приложение обязано уметь обрабатывать RDF-тройки и обеспечивать соответствующие шаблоны GRDDL для отображения существующих источников данных в RDF. Кроме того, необходимо иметь возможность в приемлимые сроки получать доступ к RDF-тройкам через веб-сервисы, сервлеты или другое программное обеспечение с открытым  для использования API. И последняя компонента, одна из наиболее сложных, - интерфейс пользователя, который должен поддерживать доступ с различных устройств, различные протоколы и типы доступа. Все компоненты семантического приложения должны поддерживать стандарты Semantic Web, утвержденные консорциумом W3C, для обеспечения способности к взаимодействию с различными системами на разных уровнях.

Таким образом, для реализации семантического приложения необходима реализация следующего минимального набора компонент:


1.    Хранилища RDF-триплетов.
2.    Средства обработки RDF-триплетов.
3.    Средства визуализации RDF-триплетов.
4.    Интерфейс пользователя.
5.    Средства интеграции со сторонними сервисами.
 

На сегодняшний день эффективные компоненты 1,2  уже реализованы и могут быть подобраны с учетом специфики семантического приложения. Компоненты 3-5 должны быть реализованы с учетом специфики задачи, которую необходимо решить. Несмотря на широкий круг задач, которые можно решать с помошью Semantic Web, предложим унифицированный набор компонентов (шаблон), которые можно применить в любом семантическом приложении: 

1)    Набор предопределенных Sparql-запросов, которые позволят  дать базовую функциональность приложению и типовой интерфейс пользователя.
 

2)    Система рейтингования выводимой информации (предопределенный набор фильтров).
 

3)    Ассистент запросов - средство для упрощения создания произвольных запросов к приложению.  Это необходимо прежде всего для оценки сложности запроса, вводимого пользователем, и предотвращения возможности выполнения заведомо невыполнимых запросов.
 

4)    Аггрегатор  RSS/Atom новостных лент для обеспечения возможности пополнения приложения новой информацией.
 

Как можно заметить, все предложенные компоненты направлены на ограничение возможностей пользователя в доступе к данным, которые можно было получить через открытую среду Semantic Web. Это связано, прежде всего, с необходимостью учитывать вопросы производительности приложения при подключении большого числа пользователей и возможностью создания запросов в Semantic Web, которые не могут быть выполнены за конечное время. Это может привести к тому, что пользователь не дождется конца выполнения запроса и вынужден будет поменять провайдера приложений.


Дальше


Начало    -- 2 --     -- 3 --     4      -- 5 --


SW-applications-3

РАЗРАБОТКА РАСПРЕДЕЛЕННЫХ СЕМАНТИЧЕСКИХ ПРИЛОЖЕНИЙ КАК СТРАТЕГИЯ РАЗВИТИЯ СОВРЕМЕННОГО WEB (Продолжение)


Начало    -- 2 --     3      -- 4 --      -- 5 --


Язык запросов становится более мощным за счет разрешения запросов, включающих знаки подстановки (wild cards), диапазоны (ranges) и подзапросы. Например, запрос

[[Category:Conference]] [[start date:=>May 18 2010]] [[program chair::[[member of::НАНУ]]]]

означает выбрать все конференции, которые начались после 18 мая 2010 года и которые находятся под руководством организаций-членов Национальной Академии Наук Украины. Нужно также отметить, что запросы категории членства (category membership) дадут ограниченную (но не полную) форму аргументации для учета отношений подкласса (subclass relationships). 

Возможности SMW в построении запросов могут использоваться для встраивания в страницы динамического контента, что является основным преимуществом по сравнению с традиционными вики-системами. Для того, чтобы это сделать, достаточно поместить в теги изапрос, написанный как вики-текст. В статье (на странице), которая содержит запрос, теги будут заменены на результаты выполнения данного запроса. Более того, синтаксис запросов предполагает утверждения для отображения дальнейших свойств полученных результатов и для изменения формы выдачи внутри страницы. 

Например, главная страница ontoworld.org отображает предстоящие события, их даты и места проведения. Эти результаты генерируются динамически: производится поиск конференций, дата начала которых больше текущей, результаты упорядочиваются в соответствии с датами и выводятся первые пять результатов [3].

Как указывалось выше, каждая статья представляет собой онтологический элемент, т.е. элемент одного из RDF-классов - Thing, Class, ObjectProperty, DatatypeProperty, AnnotationProperty. Кроме того, каждой статье нужен URI, который во избежание путаницы между понятиями и HTML-страницами отличается от своего URL. Каждый URL в SMW инъективно отображается в URI, который при запросе броузера перенаправляется к первоначальному URL. URL не может использоваться, поскольку OWL/RDF требует использования в качестве идентификаторов XML URI, которые, в свою очередь, не могут использовать все символы, разрешенные в URL.

Тип элементов для большинства видов аннотаций является фиксированным. Обычно статьи являются только OWL-экземплярами, категории становятся классами, а отношения становятся OWL-отношениями (object properties) между статьями. Атрибуты, в зависимости от своего типа в вики-системе, могут иметь свойства типа данных (datatype), свойство аннотации, или объекта (object properties).

Исходя из этого отображения, для любой страницы SMW по запросу генерирует OWL/RDF. Простейший способ получить этот RDF - использовать ссылку "Просмотреть как RDF" ("View as RDF"), находящуюся в нижней части каждой проаннотированной страницы. Более подробную информацию о настройках экспорта, который также позволяет осуществлять черновой экспорт основной части (bulk), включение обратных ссылок и рекурсивный экспорт, можно найти на специальной странице [2]. Эта страница также выступает в качестве конечной точки (endpoint) для внешних сервисов (внешней точки доступа), которые хотят получить доступ к семантическим данным вики.

Поскольку SMW совместима с моделью знаний OWL DL, то существует возможность использования в вики-проектах существующих онтологий. Это возможно двумя путями: 
  • импорт онтологии (ontology import), который позволяет создавать и модифицировать страницы в вики-системе для представления отношений, заданных в некотором существующем OWL DL-документе;
  • повторное использование словаря (vocabulary reuse) - позволяет пользователям отображать (задавать соответствия) вики-страницы на элементы существующих онтологий.

Функция импорта онтологии для чтения RDF-документов использует инструментарий RAP toolkit [3]. Он извлекает RDF-утверждения, которые могут быть представлены в вики-системе. Наименования статей импортируемых элементов извлекаются из их меток (labels) или, в случае отсутствия метки, из идентификатора раздела их URI. Основной целью импорта является инициализация (автоматическая загрузка) основы-шаблона для заполнения контента вики-проекта. Кроме того, импорт онтологии вставляет специальные аннотации, которые генерируют эквивалентные утверждения в OWL (т.е.. owl:sameAs, owl:equivalentClass, или owl:equivalentProperty). Импорт онтологий разрешен только для администраторов сайта, поскольку это может быть использовано для спама вики-проекта тысячами новых статей.

Импорт словаря позволяет пользователям идентифицировать элементы вики-системы, указав связь с элементами существующих онтологий. Например, Category:Person напрямую экспортируется в класс foaf:Person словаря Friend-Of-A-Friend. Вики-пользователи могут решать, какие вики-страницы должны иметь внешнюю семантику, однако набор имеющихся внешних элементов управляется только администраторами. Вводя в словарь вики-проекта некоторый новый элемент, они должны удостовериться в том, что повторное использование словаря соотносится с типами ограничений OWL DL. Например, внешние классы, такие как foaf:Person, не могут быть импортированы в Отношения.

Экспорт в OWL/RDF является средством обеспечения внешнего повторного использования данных вики-систем, но только практическое приложение этой функции может показать качество генерируемого RDF. С этой целью для выдачи RDF разработчики системы использовали ряд инструментов Semantic Web. SMW хорошо сотрудничало с наиболее оттестированными приложениями, такими, как FOAF Explorer, Tabulator RDF browser или расширением броузера Piggy Bank RDF. Подробная информация об испытанных инструментариях, включая их основные функции и URL, приведены в [4].

Кроме того, SMW предоставляет сервис SPARQL-запросов. Система базируется на автономном (stand-alone) RDF-сервере Joseki, который синхронизирован с семантически размеченным содержимым вики-системы. Синхронизация заключается в том, что генерируется RSS-фид с отчетом о последних изменениях в вики-проекте, для того, чтобы быстро перезагрузить измененные статьи. Таким образом, SPARQL-точка (endpoint) демонстрирует возможность зеркально отобразить (to mirror) RDF-контент вики-проекта при помощи небольших пошаговых обновлений, и предлагает точку доступа для семантических проектов, повторно использующих данные.

Необходимо также упомянуть и другие функции Semantic MediaWiki, такие как использование семантических шаблонов или поддержка единиц измерения[4]. 

Несмотря на множество вышеперечисленных достоинств, Semantic MediaWiki является специализированным решением для конкретных типов информационных ресурсов, которые строятся на базе вики-систем. В то же время необходимо отметить стремительный рост количества программных средств низкоуровнего управления триплетами RDF. Эти средства получили название хранилища триплетов (triple store) и представляют собой функциональный аналог традиционных реляционных СУБД.

Рассмотрим вариант создания семантического приложения на базе хранилищ триплетов.

Дальше


Начало    -- 2 --     3      -- 4 --      -- 5 --


SW-applications-2

РАЗРАБОТКА РАСПРЕДЕЛЕННЫХ СЕМАНТИЧЕСКИХ ПРИЛОЖЕНИЙ КАК СТРАТЕГИЯ РАЗВИТИЯ СОВРЕМЕННОГО WEB (Продолжение)


Начало     2     ---  3 ---      -- 4 --         -- 5 --


Анализ технологических решений семантических приложений Web

Semantic MediaWiki (SMW) является развитием MediaWiki - широко используемой системы управления вики-системой, которая используется в Википедии, и представляет собой приложение, позволяющее пользователям аннотировать содержимое вики путем ввода явно опеределенной, машинночитаемой семантической информации. 

SMW основывается на простом и ненавязчивом механизме семантической аннотации. Пользователям для использования на страницах вики-текста предоставляется специальная разметка, а SMW отображает эти аннотации с помощью языка онтологий OWL DL в формальное представление. Для использования семантических данных SMW поддерживает простой, но мощный язык запросов. При помощи встраивания запросов в вики-текст, пользователи могут создавать динамические страницы, включающие результаты запроса.

SMW также предоставляет различные интерфейсы к данным и инструментам Semantic Web. Формальные описания в OWL/RDF-формате для одной или более статей (статья - содержимое  веб-страницы вики-системы) могут быть получены из веб-интерфейса, что предоставляет возможность внешнего использования. Можно также импортировать данные из существующих онтологий OWL, и отображать вики-аннотации на существующие словари, такие, как FOAF. 

Поскольку SMW строго придерживается стандарта OWL DL, экспортируемая информация может быть повторно использована в различных приложениях. Каждая статья вики соответствует только одному онтологическому элементу (в том числе классам и свойствам), и каждая аннотация в статье делает утверждения об этом одном элементе. Такое ограничение имеет решающее значение для эксплуатации: поскольку знания повторно используются в различных местах, пользователи должны по-прежнему иметь возможность понимать, откуда первоначально поступила информация. Кроме того, все аннотации ссылаются на (абстрактный) концепт, представленный страницей. Формально это осуществляется путем выбора для статей соответствующих URI [2].

Большинство аннотаций, которые встречаются в SMW, соответствуют простым утверждениям ABox (ABox statements - «assertion component») на языке OWL DL, например, они описывают определенных людей, задавая отношения между ними, аннотируя их значениями данных, или классифицируя их. Схематическая информация (TBox - «terminological component» - словарь, с которым ассоциирован набор фактов ABox), представимая в SMW, умышленно неглубока. Редактор онтологий в вики в качестве основной цели не был предусмотрен, поскольку инженерия распределенных онтологий и крупномасштабные логические выводы в настоящее время пока еще проблематичны. Однако SMW была использована в сочетании с более выразительными базовыми онтологиями, которые затем обрабатывались внешними OWL подсистемами логического вывода [1].

Рассмотрим основные понятия онтологии, используемые в SMW и, называемые в дальнейшем аннотациями – категории, отношения и атрибуты.

Категории являются простой формой аннотации, которая позволяет пользователям классифицировать страницы. Категории уже были возможны в MediaWiki, а SMW лишь наделило их формальной интерпретацией в качестве классов OWL. Для того, чтобы указать, что статья «ИАИ2010» принадлежит категории «Конференции», надо просто вставить внутри статьи о ИАИ2010 соответствующее указание: [[Category:Conference]].

Отношения описывают связи между двумя статьями при помощи присвоения имени отношения существующим на веб-странице ссылкам. Например, необходимо указать связь между программой ИАИ-2010 и кафедрой НТУ КПИ. Для того, чтобы выразить это, пользователю надо просто отредактировать страницу «ИАИ-2010», изменив нормальную ссылку [[НТУ КПИ]] на [[program chair:: НТУ КПИ]].

Атрибуты позволяют пользователям определить взаимоотношения статей к сущностям, которые не являются статьями. Например, можно сообщить, что датой начала ИАИ-2010 является 18 мая 2010, указав в документе [[start date:=May 18 2010]]. В большинстве случаев, указания отношения к новой странице «May 18 2010» не требуется. Кроме того, система должна понимать смысл определенной даты, и распознавать эквивалентные значения, такие как 2010-05-18.

Аннотации (категории, отношения и атрибуты), как правило, в том месте, где они вставлены, не отображаются. Ссылки на категории появляются только в нижней части страницы, отношения отображаются как обычные ссылки, а атрибуты показывают только заданное значение. Внизу каждой страницы находится область для быстрого перемещения - factbox, она позволяет пользователям просматривать все полученные аннотации, сохраняя при этом основной текст нетронутым.

Очевидно, что обработка атрибутов требует некоторой дополнительной информации о типе (Type) аннотации. Целые числа, строки, даты – все они требуют разной обработки, и необходимо, чтобы кто-либо задавал этот тип. Как указано выше, каждый онтологический элемент - категория, отношение и атрибут - представлен в виде статьи. Это также дает преимущество в том, что пользовательская документация может быть написана для каждого элемента словаря, что имеет решающее значение для согласованности при использовании аннотации.

Типы, которые возможны для атрибутов, также имеют выделенные статьи. Чтобы определить тип в приведенном выше примере, просто нужно указать отношение между атрибутом Attribute:start date и типом Type:Date. Это отношение называется «has type», и оно имеет специальный встроенный смысл. Кроме того, в OWL DL оно рассматривается как owl:AnnotationProperty. SMW имеет ряд аналогичных специальных свойств, которые используются для спецификации некоторых технических аспектов системы, но большинство пользователей может свободно повторно использовать существующие аннотации без всякого беспокойства об основных определениях.

Как уже упоминалось выше, внизу каждой статьи отображается область для быстрой навигации - factbox, которая предоставляет функции быстрых ссылок – quicklinks, используемых для просмотра и поиска. Например, атрибуты, которые обозначают географические координаты, дают ссылки на сервисы интерактивной карты. Однако главным преимуществом для пользователей вики-систем является возможность задавать SMW-запросы.

Пользователи могут искать статьи, используя простой язык запросов, разработанный на основе известного синтаксиса вики-систем. Более того, запрос для поиска всех статей, которые содержат «НТУ КПИ» в качестве месторасположения руководящего органа программы, выглядит просто: [[program chair:: НТУ КПИ]]. Иными словами, синтаксис для определения аннотации идентичен синтаксису для ее поиска. Множество таких запросов интерпретируются конъюнктивно.

Дальше


Начало     2     ---  3 ---      -- 4 --         -- 5 --

SW-applications-1

РАЗРАБОТКА РАСПРЕДЕЛЕННЫХ СЕМАНТИЧЕСКИХ ПРИЛОЖЕНИЙ КАК СТРАТЕГИЯ РАЗВИТИЯ СОВРЕМЕННОГО WEB

И.Ю.Гришанова1, С.С. Щербак2

1Институт программных систем НАН Украины
2Харьковский национальный университет радиоэлектроники

Рассмотрены технологические аспекты применения программных средств в гипертекстовом Web и проведен анализ существующих реализаций семантических приложений. Представлено интенсиональное определение приложения Semantic Web, принятое на данный момент, его архитектура, определен перечень обязательных к реализации функций семантических приложений Web, а также их спецификация. Предложен унифицированный шаблон семантического приложения и приведены рекомендации по его применению. 

Ключевые слова: OWL, RDF store, онтологии, триплеты, семантика, интеллектуальный поиск

Введение. Роль парадигмы Semantic Web в развитии современного WWW


Последние несколько лет  характеризуются повышенным вниманием к перспективной концепции Semantic Web, которая позволяет применить интеллектуальные мультиагентные системы для решения практических задач на основе данных, распределенных по WWW.
Основные исследования, проводимые в рамках Semantic Web, направлены на представление информации в машинно-обрабатываемой форме, а именно – в виде связанных данных, структура и семантика которых явно определена с помощью онтологий. О подобном машинно-понятном представлении говорят, что оно  семантически размечено.

На сегодняшний день в Web накоплено большое количество семантически размеченной информации. Причем наблюдается постоянный рост объемов подобной информации, что отчасти стимулируется внедрением поддержки технологий Semantic Web современными машинами поиска, такими как Google и Yandex. В то же время наблюдается отсутствие четкой стратегии и рекомендаций по использованию такой информации в программных приложениях, что затрудняет их создание и использование. В качестве решения этой задачи авторы предлагают ряд рекомендаций и шаблон семантического приложения. 

Необходимо также отметить, что данная работа направлена на поддержку в актуальном состоянии интенсионального определения семантического приложения Web, а также позволяет более точно определить характеристики современных семантических приложений.


Интероперабельные семантические приложения современного Web


Современный Web представляет собой огромный часто обновляемый источник информации, но зачастую этой информацией просто невозможно воспользоваться, поскольку ее объемы даже на узкоспециализированные запросы могут быть очень большими. Пусть нас интересует информация о некотором событии в нашем городе, но в результате поиска мы получим сотни различных ссылок на документы, которые могут весьма косвенно относиться к нашему запросу.

Естественно, заниматься перебором всех документов не имеет смысла, так как это приведет к большим затратам времени. Например, даже при поиске в вики-системах, подобных Википедии, содержащих тысячи страниц, поиск подобной информации может сильно затянуться. 

Для решения подобных проблем и была предложена концепция Semantic Web, в рамках которой каждый документ размечается или аннотируется с помощью одного из языков семантической разметки. Например, с помощью RDF или RDFa. Это позволяет проводить машинам поиска не полнотекстовый поиск по документам, а выполнять специализированные запросы на языке Sparql к источникам семантически размеченной информации или семантическим хранилищам. 

Необходимо отметить, что количество подобных источников меньше, чем количество тематических информационных ресурсов, но их число постоянно растет.  В то же время, запрос, составленный на Sparql  дает более точный результат, и мы можем надеятся получить факт или набор фактов, которые дадут нам точный ответ о всех потенциальных событиях, которые должны произойти в городе. 

Подобные технологии открывают широкие возможности по организации использования информации в различных прикладных задачах. С другой стороны, процедура семантической разметки документов весьма трудоемка и требует специализированных знаний, что служило долгое время препятствием для ее повсеместного внедрения.  В настоящее время большинство пользователей для управления своим информационным ресурсом пользуется либо автономной системой управления контентом (CMS), либо использует один из множества сервисов по ведению бесплатных блогов, сайтов или сообществ, что позволяет централированно внедрять поддержку интерфейсов по автоматической или автоматизированной семантической разметке публикуемых в блоге или на сайте документов. Рассмотрим в качестве примера расширение популярной вики-системы Semantic MediaWiki.


1   -- 2 --    ---  3 ---      -- 4 --        -- 5 --

Популярное

Использование материалов сайта

Информация, представленная на сайте, может свободно использоваться и распространяться при обязательном указании активной прямой ссылки на сайт http://in-search-of-semantics.blogspot.com/, а тексты научных статей – при указании авторства и ссылки на бумажную публикацию.

При размещении текстов статей на своих сайтах, блогах и пр., пожалуйста, присылайте ссылки.
Комментарии перед публикацией предварительно модерируются.

Хотите сказать спасибо автору? Не откажусь :) - Поставьте ретвит на пост, или другую социальную закладку. Спасибо.