Социализируемся

Я в Google+ Я в Twitter Я в Facebook

Showing posts with label Публікації. Show all posts

Wednesday, November 3, 2010

SW-applications-5

РАЗРАБОТКА РАСПРЕДЕЛЕННЫХ СЕМАНТИЧЕСКИХ ПРИЛОЖЕНИЙ КАК СТРАТЕГИЯ РАЗВИТИЯ СОВРЕМЕННОГО WEB (Продолжение)


Начало


Выводы


Подводя итоги, отметим, что увеличение количества семантических приложений позволит увеличить объемы создаваемой семантически размеченной информации и будет повышать интеллектуальные способности  программных систем. Кроме того, применение компонентов предлагаемого шаблона позволит создать предопределенный набор действий, который позволит семнатическому приложению эффективно решать задачу пользователя.

Список литературы

1.      Barnell A. Building Blocks for Semantic Web Applications. // Доступно на www.w3c.rl.ac.uk/Euroweb/slides/rdfobjects3.ppt
2.      Krötzsch M., Vrande¡ci D., Völkel M. Semantic MediaWiki //The 5th International Semantic Web Conference.- Athens(USA). Доступно на http://korrekt.org/papers/KroetzschVrandecicVoelkel_ISWC2006.pdf
3.      Völkel, M., Krötzsch, M., Vrande¡ci´c, D., Haller, H., Studer, R. Semantic Wikipedia // Proc. of the 15th International WWW Conference. -  Edinburgh(Scotland). -2006.
4.      Krötzsch, M., Vrande¡ci´c, D., Völkel, M. Wikipedia and the Semantic Web, Part II. // Proc. of the 2nd International Wikimedia Conference, Wikimania. - Cambridge (USA). – 2006
Андон Ф.И., Гришанова И.Ю., Резниченко В.А. "Semantic Web как новая модель инормационного пространства интернет", Проблеми програмування. 2008. № 2-3, 417-430.

SW-applications-4

РАЗРАБОТКА РАСПРЕДЕЛЕННЫХ СЕМАНТИЧЕСКИХ ПРИЛОЖЕНИЙ КАК СТРАТЕГИЯ РАЗВИТИЯ СОВРЕМЕННОГО WEB (Продолжение)


Начало    -- 2 --     -- 3 --     4      -- 5 --


Унифицированный шаблон семантического приложения Web

 Web, в отличие от понятия Интернет, представляет собой сеть html-документов, связанных между собой гиперссылками. Семантический веб (Semantic Web) на данный момент представляет собой RDF-документы и базы данных, машинно-обрабатываемые данные, онтологии и подсистемы логического вывода [5]. Вопросы доказательства и доверия пока остаются открытыми.

Semantic Web представляет собой уровень открытой базы данных, надстроенный над вебом (см. Рисунок 1) [4].
Рисунок 1. Semantic Web как уровень открытой базы данных в Web.

Базовые открытые стандарты Semantic Web следующие:

  •      RDF - обеспечивает хранение данных в виде троек;
  •      OWL - определяет системы концептов, называемые онтологиями;
  •      SPARQL - язык запросов к RDF;
  •      SWRL - определяет правила;
  •      GRDDL - предназначен для преобразования данных в формат RDF.
В данном контексте определим понятие "семантическое приложение Web".

Семантическое приложение Web - это приложение, которое работает в соответствии со стандартами Semantic Web, создает и использует "машинно-читаемые" данные и обладает конструктивными особенностями веба, например, работает с распределенными онтологиями и/или данными.


Кроме того, необходимо отметить, что семантическое приложение должно воспринимать открытый мир; это значит, что оно должно знать, что информация никогда не бывает полной.
Во-вторых, приложение должно использовать некоторое формальное описание семантики данных. 


В-третьих, семантическое приложение должно использовать информационные источники, которые:

  •      географически распределены;
  •      имеют разных собственников, и, следовательно, отсутствует контроль за развитием данного источника;
  •      являются гетерогенными (синтаксически, структурно и семантически);
  •      содержат данные реального мира, т.е. источники должны быть относительно большими.
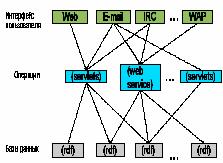
Согласно концепции Semantic Web на самом нижнем уровне семантическому приложению необходимо работать с  наборами RDF-троек, представляющих собой реализацию модели "объект-атрибут-значение" (см. Рисунок 2). Это позволяет обеспечить универсальный промежуточный слой между реальными источниками данных, которые представлены в различных форматах и структурах.


Рисунок 2. Архитектура семантических приложений Semantic Web

Таким образом, семантическое приложение обязано уметь обрабатывать RDF-тройки и обеспечивать соответствующие шаблоны GRDDL для отображения существующих источников данных в RDF. Кроме того, необходимо иметь возможность в приемлимые сроки получать доступ к RDF-тройкам через веб-сервисы, сервлеты или другое программное обеспечение с открытым  для использования API. И последняя компонента, одна из наиболее сложных, - интерфейс пользователя, который должен поддерживать доступ с различных устройств, различные протоколы и типы доступа. Все компоненты семантического приложения должны поддерживать стандарты Semantic Web, утвержденные консорциумом W3C, для обеспечения способности к взаимодействию с различными системами на разных уровнях.

Таким образом, для реализации семантического приложения необходима реализация следующего минимального набора компонент:


1.    Хранилища RDF-триплетов.
2.    Средства обработки RDF-триплетов.
3.    Средства визуализации RDF-триплетов.
4.    Интерфейс пользователя.
5.    Средства интеграции со сторонними сервисами.
 

На сегодняшний день эффективные компоненты 1,2  уже реализованы и могут быть подобраны с учетом специфики семантического приложения. Компоненты 3-5 должны быть реализованы с учетом специфики задачи, которую необходимо решить. Несмотря на широкий круг задач, которые можно решать с помошью Semantic Web, предложим унифицированный набор компонентов (шаблон), которые можно применить в любом семантическом приложении: 

1)    Набор предопределенных Sparql-запросов, которые позволят  дать базовую функциональность приложению и типовой интерфейс пользователя.
 

2)    Система рейтингования выводимой информации (предопределенный набор фильтров).
 

3)    Ассистент запросов - средство для упрощения создания произвольных запросов к приложению.  Это необходимо прежде всего для оценки сложности запроса, вводимого пользователем, и предотвращения возможности выполнения заведомо невыполнимых запросов.
 

4)    Аггрегатор  RSS/Atom новостных лент для обеспечения возможности пополнения приложения новой информацией.
 

Как можно заметить, все предложенные компоненты направлены на ограничение возможностей пользователя в доступе к данным, которые можно было получить через открытую среду Semantic Web. Это связано, прежде всего, с необходимостью учитывать вопросы производительности приложения при подключении большого числа пользователей и возможностью создания запросов в Semantic Web, которые не могут быть выполнены за конечное время. Это может привести к тому, что пользователь не дождется конца выполнения запроса и вынужден будет поменять провайдера приложений.


Дальше


Начало    -- 2 --     -- 3 --     4      -- 5 --


SW-applications-3

РАЗРАБОТКА РАСПРЕДЕЛЕННЫХ СЕМАНТИЧЕСКИХ ПРИЛОЖЕНИЙ КАК СТРАТЕГИЯ РАЗВИТИЯ СОВРЕМЕННОГО WEB (Продолжение)


Начало    -- 2 --     3      -- 4 --      -- 5 --


Язык запросов становится более мощным за счет разрешения запросов, включающих знаки подстановки (wild cards), диапазоны (ranges) и подзапросы. Например, запрос

[[Category:Conference]] [[start date:=>May 18 2010]] [[program chair::[[member of::НАНУ]]]]

означает выбрать все конференции, которые начались после 18 мая 2010 года и которые находятся под руководством организаций-членов Национальной Академии Наук Украины. Нужно также отметить, что запросы категории членства (category membership) дадут ограниченную (но не полную) форму аргументации для учета отношений подкласса (subclass relationships). 

Возможности SMW в построении запросов могут использоваться для встраивания в страницы динамического контента, что является основным преимуществом по сравнению с традиционными вики-системами. Для того, чтобы это сделать, достаточно поместить в теги изапрос, написанный как вики-текст. В статье (на странице), которая содержит запрос, теги будут заменены на результаты выполнения данного запроса. Более того, синтаксис запросов предполагает утверждения для отображения дальнейших свойств полученных результатов и для изменения формы выдачи внутри страницы. 

Например, главная страница ontoworld.org отображает предстоящие события, их даты и места проведения. Эти результаты генерируются динамически: производится поиск конференций, дата начала которых больше текущей, результаты упорядочиваются в соответствии с датами и выводятся первые пять результатов [3].

Как указывалось выше, каждая статья представляет собой онтологический элемент, т.е. элемент одного из RDF-классов - Thing, Class, ObjectProperty, DatatypeProperty, AnnotationProperty. Кроме того, каждой статье нужен URI, который во избежание путаницы между понятиями и HTML-страницами отличается от своего URL. Каждый URL в SMW инъективно отображается в URI, который при запросе броузера перенаправляется к первоначальному URL. URL не может использоваться, поскольку OWL/RDF требует использования в качестве идентификаторов XML URI, которые, в свою очередь, не могут использовать все символы, разрешенные в URL.

Тип элементов для большинства видов аннотаций является фиксированным. Обычно статьи являются только OWL-экземплярами, категории становятся классами, а отношения становятся OWL-отношениями (object properties) между статьями. Атрибуты, в зависимости от своего типа в вики-системе, могут иметь свойства типа данных (datatype), свойство аннотации, или объекта (object properties).

Исходя из этого отображения, для любой страницы SMW по запросу генерирует OWL/RDF. Простейший способ получить этот RDF - использовать ссылку "Просмотреть как RDF" ("View as RDF"), находящуюся в нижней части каждой проаннотированной страницы. Более подробную информацию о настройках экспорта, который также позволяет осуществлять черновой экспорт основной части (bulk), включение обратных ссылок и рекурсивный экспорт, можно найти на специальной странице [2]. Эта страница также выступает в качестве конечной точки (endpoint) для внешних сервисов (внешней точки доступа), которые хотят получить доступ к семантическим данным вики.

Поскольку SMW совместима с моделью знаний OWL DL, то существует возможность использования в вики-проектах существующих онтологий. Это возможно двумя путями: 
  • импорт онтологии (ontology import), который позволяет создавать и модифицировать страницы в вики-системе для представления отношений, заданных в некотором существующем OWL DL-документе;
  • повторное использование словаря (vocabulary reuse) - позволяет пользователям отображать (задавать соответствия) вики-страницы на элементы существующих онтологий.

Функция импорта онтологии для чтения RDF-документов использует инструментарий RAP toolkit [3]. Он извлекает RDF-утверждения, которые могут быть представлены в вики-системе. Наименования статей импортируемых элементов извлекаются из их меток (labels) или, в случае отсутствия метки, из идентификатора раздела их URI. Основной целью импорта является инициализация (автоматическая загрузка) основы-шаблона для заполнения контента вики-проекта. Кроме того, импорт онтологии вставляет специальные аннотации, которые генерируют эквивалентные утверждения в OWL (т.е.. owl:sameAs, owl:equivalentClass, или owl:equivalentProperty). Импорт онтологий разрешен только для администраторов сайта, поскольку это может быть использовано для спама вики-проекта тысячами новых статей.

Импорт словаря позволяет пользователям идентифицировать элементы вики-системы, указав связь с элементами существующих онтологий. Например, Category:Person напрямую экспортируется в класс foaf:Person словаря Friend-Of-A-Friend. Вики-пользователи могут решать, какие вики-страницы должны иметь внешнюю семантику, однако набор имеющихся внешних элементов управляется только администраторами. Вводя в словарь вики-проекта некоторый новый элемент, они должны удостовериться в том, что повторное использование словаря соотносится с типами ограничений OWL DL. Например, внешние классы, такие как foaf:Person, не могут быть импортированы в Отношения.

Экспорт в OWL/RDF является средством обеспечения внешнего повторного использования данных вики-систем, но только практическое приложение этой функции может показать качество генерируемого RDF. С этой целью для выдачи RDF разработчики системы использовали ряд инструментов Semantic Web. SMW хорошо сотрудничало с наиболее оттестированными приложениями, такими, как FOAF Explorer, Tabulator RDF browser или расширением броузера Piggy Bank RDF. Подробная информация об испытанных инструментариях, включая их основные функции и URL, приведены в [4].

Кроме того, SMW предоставляет сервис SPARQL-запросов. Система базируется на автономном (stand-alone) RDF-сервере Joseki, который синхронизирован с семантически размеченным содержимым вики-системы. Синхронизация заключается в том, что генерируется RSS-фид с отчетом о последних изменениях в вики-проекте, для того, чтобы быстро перезагрузить измененные статьи. Таким образом, SPARQL-точка (endpoint) демонстрирует возможность зеркально отобразить (to mirror) RDF-контент вики-проекта при помощи небольших пошаговых обновлений, и предлагает точку доступа для семантических проектов, повторно использующих данные.

Необходимо также упомянуть и другие функции Semantic MediaWiki, такие как использование семантических шаблонов или поддержка единиц измерения[4]. 

Несмотря на множество вышеперечисленных достоинств, Semantic MediaWiki является специализированным решением для конкретных типов информационных ресурсов, которые строятся на базе вики-систем. В то же время необходимо отметить стремительный рост количества программных средств низкоуровнего управления триплетами RDF. Эти средства получили название хранилища триплетов (triple store) и представляют собой функциональный аналог традиционных реляционных СУБД.

Рассмотрим вариант создания семантического приложения на базе хранилищ триплетов.

Дальше


Начало    -- 2 --     3      -- 4 --      -- 5 --


SW-applications-2

РАЗРАБОТКА РАСПРЕДЕЛЕННЫХ СЕМАНТИЧЕСКИХ ПРИЛОЖЕНИЙ КАК СТРАТЕГИЯ РАЗВИТИЯ СОВРЕМЕННОГО WEB (Продолжение)


Начало     2     ---  3 ---      -- 4 --         -- 5 --


Анализ технологических решений семантических приложений Web

Semantic MediaWiki (SMW) является развитием MediaWiki - широко используемой системы управления вики-системой, которая используется в Википедии, и представляет собой приложение, позволяющее пользователям аннотировать содержимое вики путем ввода явно опеределенной, машинночитаемой семантической информации. 

SMW основывается на простом и ненавязчивом механизме семантической аннотации. Пользователям для использования на страницах вики-текста предоставляется специальная разметка, а SMW отображает эти аннотации с помощью языка онтологий OWL DL в формальное представление. Для использования семантических данных SMW поддерживает простой, но мощный язык запросов. При помощи встраивания запросов в вики-текст, пользователи могут создавать динамические страницы, включающие результаты запроса.

SMW также предоставляет различные интерфейсы к данным и инструментам Semantic Web. Формальные описания в OWL/RDF-формате для одной или более статей (статья - содержимое  веб-страницы вики-системы) могут быть получены из веб-интерфейса, что предоставляет возможность внешнего использования. Можно также импортировать данные из существующих онтологий OWL, и отображать вики-аннотации на существующие словари, такие, как FOAF. 

Поскольку SMW строго придерживается стандарта OWL DL, экспортируемая информация может быть повторно использована в различных приложениях. Каждая статья вики соответствует только одному онтологическому элементу (в том числе классам и свойствам), и каждая аннотация в статье делает утверждения об этом одном элементе. Такое ограничение имеет решающее значение для эксплуатации: поскольку знания повторно используются в различных местах, пользователи должны по-прежнему иметь возможность понимать, откуда первоначально поступила информация. Кроме того, все аннотации ссылаются на (абстрактный) концепт, представленный страницей. Формально это осуществляется путем выбора для статей соответствующих URI [2].

Большинство аннотаций, которые встречаются в SMW, соответствуют простым утверждениям ABox (ABox statements - «assertion component») на языке OWL DL, например, они описывают определенных людей, задавая отношения между ними, аннотируя их значениями данных, или классифицируя их. Схематическая информация (TBox - «terminological component» - словарь, с которым ассоциирован набор фактов ABox), представимая в SMW, умышленно неглубока. Редактор онтологий в вики в качестве основной цели не был предусмотрен, поскольку инженерия распределенных онтологий и крупномасштабные логические выводы в настоящее время пока еще проблематичны. Однако SMW была использована в сочетании с более выразительными базовыми онтологиями, которые затем обрабатывались внешними OWL подсистемами логического вывода [1].

Рассмотрим основные понятия онтологии, используемые в SMW и, называемые в дальнейшем аннотациями – категории, отношения и атрибуты.

Категории являются простой формой аннотации, которая позволяет пользователям классифицировать страницы. Категории уже были возможны в MediaWiki, а SMW лишь наделило их формальной интерпретацией в качестве классов OWL. Для того, чтобы указать, что статья «ИАИ2010» принадлежит категории «Конференции», надо просто вставить внутри статьи о ИАИ2010 соответствующее указание: [[Category:Conference]].

Отношения описывают связи между двумя статьями при помощи присвоения имени отношения существующим на веб-странице ссылкам. Например, необходимо указать связь между программой ИАИ-2010 и кафедрой НТУ КПИ. Для того, чтобы выразить это, пользователю надо просто отредактировать страницу «ИАИ-2010», изменив нормальную ссылку [[НТУ КПИ]] на [[program chair:: НТУ КПИ]].

Атрибуты позволяют пользователям определить взаимоотношения статей к сущностям, которые не являются статьями. Например, можно сообщить, что датой начала ИАИ-2010 является 18 мая 2010, указав в документе [[start date:=May 18 2010]]. В большинстве случаев, указания отношения к новой странице «May 18 2010» не требуется. Кроме того, система должна понимать смысл определенной даты, и распознавать эквивалентные значения, такие как 2010-05-18.

Аннотации (категории, отношения и атрибуты), как правило, в том месте, где они вставлены, не отображаются. Ссылки на категории появляются только в нижней части страницы, отношения отображаются как обычные ссылки, а атрибуты показывают только заданное значение. Внизу каждой страницы находится область для быстрого перемещения - factbox, она позволяет пользователям просматривать все полученные аннотации, сохраняя при этом основной текст нетронутым.

Очевидно, что обработка атрибутов требует некоторой дополнительной информации о типе (Type) аннотации. Целые числа, строки, даты – все они требуют разной обработки, и необходимо, чтобы кто-либо задавал этот тип. Как указано выше, каждый онтологический элемент - категория, отношение и атрибут - представлен в виде статьи. Это также дает преимущество в том, что пользовательская документация может быть написана для каждого элемента словаря, что имеет решающее значение для согласованности при использовании аннотации.

Типы, которые возможны для атрибутов, также имеют выделенные статьи. Чтобы определить тип в приведенном выше примере, просто нужно указать отношение между атрибутом Attribute:start date и типом Type:Date. Это отношение называется «has type», и оно имеет специальный встроенный смысл. Кроме того, в OWL DL оно рассматривается как owl:AnnotationProperty. SMW имеет ряд аналогичных специальных свойств, которые используются для спецификации некоторых технических аспектов системы, но большинство пользователей может свободно повторно использовать существующие аннотации без всякого беспокойства об основных определениях.

Как уже упоминалось выше, внизу каждой статьи отображается область для быстрой навигации - factbox, которая предоставляет функции быстрых ссылок – quicklinks, используемых для просмотра и поиска. Например, атрибуты, которые обозначают географические координаты, дают ссылки на сервисы интерактивной карты. Однако главным преимуществом для пользователей вики-систем является возможность задавать SMW-запросы.

Пользователи могут искать статьи, используя простой язык запросов, разработанный на основе известного синтаксиса вики-систем. Более того, запрос для поиска всех статей, которые содержат «НТУ КПИ» в качестве месторасположения руководящего органа программы, выглядит просто: [[program chair:: НТУ КПИ]]. Иными словами, синтаксис для определения аннотации идентичен синтаксису для ее поиска. Множество таких запросов интерпретируются конъюнктивно.

Дальше


Начало     2     ---  3 ---      -- 4 --         -- 5 --

SW-applications-1

РАЗРАБОТКА РАСПРЕДЕЛЕННЫХ СЕМАНТИЧЕСКИХ ПРИЛОЖЕНИЙ КАК СТРАТЕГИЯ РАЗВИТИЯ СОВРЕМЕННОГО WEB

И.Ю.Гришанова1, С.С. Щербак2

1Институт программных систем НАН Украины
2Харьковский национальный университет радиоэлектроники

Рассмотрены технологические аспекты применения программных средств в гипертекстовом Web и проведен анализ существующих реализаций семантических приложений. Представлено интенсиональное определение приложения Semantic Web, принятое на данный момент, его архитектура, определен перечень обязательных к реализации функций семантических приложений Web, а также их спецификация. Предложен унифицированный шаблон семантического приложения и приведены рекомендации по его применению. 

Ключевые слова: OWL, RDF store, онтологии, триплеты, семантика, интеллектуальный поиск

Введение. Роль парадигмы Semantic Web в развитии современного WWW


Последние несколько лет  характеризуются повышенным вниманием к перспективной концепции Semantic Web, которая позволяет применить интеллектуальные мультиагентные системы для решения практических задач на основе данных, распределенных по WWW.
Основные исследования, проводимые в рамках Semantic Web, направлены на представление информации в машинно-обрабатываемой форме, а именно – в виде связанных данных, структура и семантика которых явно определена с помощью онтологий. О подобном машинно-понятном представлении говорят, что оно  семантически размечено.

На сегодняшний день в Web накоплено большое количество семантически размеченной информации. Причем наблюдается постоянный рост объемов подобной информации, что отчасти стимулируется внедрением поддержки технологий Semantic Web современными машинами поиска, такими как Google и Yandex. В то же время наблюдается отсутствие четкой стратегии и рекомендаций по использованию такой информации в программных приложениях, что затрудняет их создание и использование. В качестве решения этой задачи авторы предлагают ряд рекомендаций и шаблон семантического приложения. 

Необходимо также отметить, что данная работа направлена на поддержку в актуальном состоянии интенсионального определения семантического приложения Web, а также позволяет более точно определить характеристики современных семантических приложений.


Интероперабельные семантические приложения современного Web


Современный Web представляет собой огромный часто обновляемый источник информации, но зачастую этой информацией просто невозможно воспользоваться, поскольку ее объемы даже на узкоспециализированные запросы могут быть очень большими. Пусть нас интересует информация о некотором событии в нашем городе, но в результате поиска мы получим сотни различных ссылок на документы, которые могут весьма косвенно относиться к нашему запросу.

Естественно, заниматься перебором всех документов не имеет смысла, так как это приведет к большим затратам времени. Например, даже при поиске в вики-системах, подобных Википедии, содержащих тысячи страниц, поиск подобной информации может сильно затянуться. 

Для решения подобных проблем и была предложена концепция Semantic Web, в рамках которой каждый документ размечается или аннотируется с помощью одного из языков семантической разметки. Например, с помощью RDF или RDFa. Это позволяет проводить машинам поиска не полнотекстовый поиск по документам, а выполнять специализированные запросы на языке Sparql к источникам семантически размеченной информации или семантическим хранилищам. 

Необходимо отметить, что количество подобных источников меньше, чем количество тематических информационных ресурсов, но их число постоянно растет.  В то же время, запрос, составленный на Sparql  дает более точный результат, и мы можем надеятся получить факт или набор фактов, которые дадут нам точный ответ о всех потенциальных событиях, которые должны произойти в городе. 

Подобные технологии открывают широкие возможности по организации использования информации в различных прикладных задачах. С другой стороны, процедура семантической разметки документов весьма трудоемка и требует специализированных знаний, что служило долгое время препятствием для ее повсеместного внедрения.  В настоящее время большинство пользователей для управления своим информационным ресурсом пользуется либо автономной системой управления контентом (CMS), либо использует один из множества сервисов по ведению бесплатных блогов, сайтов или сообществ, что позволяет централированно внедрять поддержку интерфейсов по автоматической или автоматизированной семантической разметке публикуемых в блоге или на сайте документов. Рассмотрим в качестве примера расширение популярной вики-системы Semantic MediaWiki.


1   -- 2 --    ---  3 ---      -- 4 --        -- 5 --

Tuesday, June 15, 2010

Использование методов онтологического анализа для управления компетенциями персонала как составной части планирования научных исследований. Выводы.

Использование методов онтологического анализа для управления компетенциями персонала как составной части планирования научных исследований (5)


Выводы

В данной работе представлен новый взгляд на проблему управления персоналом в связи с появлением новых технологий в области ИТ – в частности, проекта Semantic Web и Web 2.0, а также результатов исследований в области психологии, управления компетенциями, управления талантами и пр..
Предложено на основе имеющегося инструментария ПО по управлению персоналом расширить его функционал управления компетенциями путем интеграции средств управления знаниями –, онтологического анализа, элементов логического вывода, Web-сервисов и мультиагентной парадигмы программирования. Выделены функции, которые необходимо обеспечить в системах управления онтологическими знаниями для HRM. Предполагается, что этопозволит более полно и корректно использовать человеческие ресурсы, в частности научных сотрудников, как составной части планирования научных исследований. В перспективе планируется составить общий вид модели интеллектуальной задачи и разработать алгоритм сопоставления множества моделей компетенций с моделью задачи для эффективного планирования научных исследований.

Литература

1. Армстронг М. Практика управления человеческими ресурсами. — 8-е изд. / Пер. с англ. под ред. С. К. Мордовина. — СПб.: Питер, 2008. — 832 с.
2. Бояцис Р. Компетентный менеджер. Модель эффективной работы. / Пер. с англ.— М.: HIPPO, 2008. — 352 с.
3. Спенсер С., Спенсер Л. Компетенции на работе. Пер. с англ. — М.: HIPPO, 2005. — 384 с.
4. Лесько О.Н., Рогушина Ю.В. Использование онтологий для анализа семантики естественно-языковых текстов // Проблемы программирования, № 3, 2009. – С. 59-65.
5. Рогушина Ю.В., Гладун А.Я. Використання організаційних онтологій для пошуку експертів у нових предметних областях // Проблеми програмування, № 1, 2007. – С.73-84.

Begin 2 3 4 End.

Monday, June 14, 2010

Использование технологий Semantic Web для задачи управления компетенциями

Использование методов онтологического анализа для управления компетенциями персонала как составной части планирования научных исследований. (4)


Использование технологий Semantic Web для задачи управления компетенциями

Необходимо построить теоретическую модель управления компетенциями, включающую:
1. профили компетенций и набор сервисов по их формированию, сопоставлению, хранению и анализу – аналог индекса ИПС и метаописаний ИР;
2. базу знаний, включающую онтологию ПрО, в которой решается задача, организационную онтологию и онтологию научной деятельности;
3. обобщенную модель задачи, для решения которой формируется набор исполнителей, включающую цели, которые должны быть достигнуты в результате выполнения работ, начальные данные, имеющиеся ресурсы и ограничения на процесс выполнения задачи (временные, финансовые, правовые и т.д.) -- аналог поискового запроса;
4. методы анализа и семантической разметки ЕЯ-текстов, содержащих как результаты работы кандидатов, так и описание целей и задач научного проекта – аналог средств индексирования ИР;
5. набор методов и алгоритмов, позволяющих автоматизированно по формализованному описанию научной задачи и сведениях о потенциальных исследователях сформировать набор исполнителей – собственно процедура выполнения поиска. Эти методы должны включать механизм формирования эмпирических правил и поддерживать логический вывод (аналог движка ИПС, специализированной для выбранной ПрО).
В перспективе планируется также разработка средств оптимального подбора команд исполнителей и прогнозирования эффективности их совместной работы.
Использование технологий Semantic Web обеспечит интероперабельность разрабатываемой модели и ее программной реализации, интеграции с другими ИР, БЗ и приложениями Semantic Web и возможности расширения и модификации.
Предполагается использовать следующие разработки Semantic Web, технологии Web 2.0 и средства Open Source для решения соответствующих подзадач:
1. Интеллектуальные Web-сервисы, OWL-S, сведения, доступные о людях через Web (FOAF), а также информацию, обнаруживаемую в Web с помощью интеллектуальной поисковой системы МАИПС (авт.свидетельство №32015 и № 32068 от 13.02.2010)
2. Онтологии в формате OWL, как доступные через Web (например, организационную онтологию Национальной академии наук Украины, таксономии и классификаторы), так и разработанные специально для решения конкретной задачи;
3. Онтологию задачи в формате OWL и ее расширения для конкретных ПрО;
4. RDF и средства семантической разметки, где в качестве тегов разметки используются термины соответствующих онтологий, а также методы оценки значимости ИР, аналогичные методам, которые используются в ИПС (например, индекс цитируемости Google);
5. Средства логического вывода на онтологиях, такие как Pellet, FaCT++, HermiT, Owlim
6. систему управления человеческими ресурсами OrangeHRM, средства редактирования онтологий и логического вывода и запросов к ним.
В результате анализа поставленной обобщенной задачи можно выделить следующие функции, которые необходимо обеспечить в системах управления онтологическими знаниями:
1. методы автоматизации создания и пополнения онтологии: по полтотекстовым ИР; путем обработки имеющихся метеописаний и семантической разметки; по другим онтологиям;
2. сравнение двух (или больше) разных онтологий: последовательных версий одной онтологии; онтологий, которые описывают одну ПрО, но созданные независимо друг от друга; онтологий, которые являются развитием одной онтологии для решения разных задач или разными разработчиками;
3. интеграция двух (или больше) разных онтологий: описывающих одну ПрО, но созданных независимо; развития одной онтологии для решения разных задач или разными разработчиками; описывающих разные ПрО, имеющие область пересечения терминологии (синергетика);
4. использование онтологических знаний: подтверждение или опровержение определенного факта относительно ПрО на основе соответствующей онтологии (задача, которая принципиально не всегда решается из-за того, что системы онтологических знаний используют парадигму открытого мира); поиск отношений между определенными объектами, которые описанные в онтологии, и их свойств.

Begin 2 3 4 End

Программные средства управления человеческими ресурсами

Использование методов онтологического анализа для управления компетенциями персонала как составной части планирования научных исследований. (3)


Постановка задачи

Модель компетенций является в настоящее время эффективным средством управления персоналом в различных областях деятельности, требующих системного и аргументированного подхода к выбору и оценке сотрудников. Однако ряд проблем в этой области еще не решен. Проанализировав современные методы и прикладные системы управления компетенциями, необходимо определить, какие именно средства управления знаниями (СУЗ) необходимо в них использовать и какие уже имеющиеся стандарты и технологии могут для этого применяться.

Программные средства управления человеческими ресурсами

В качестве базовой системы используется система OrangeHRM. Она автоматизирует функции по управлению персоналом в организации: наем сотрудников, администрирование поощрений и выплат, управление рабочим временем работников.
OrangeHRM (http://www.orangehrm.com) – система управления персоналом с открытым кодом, которая разрабатывается по принципу открытых источников, имеет открытые программные коды и распространяется по свободной лицензии GPL. Эта система имеет модульную архитектуру и является Web-ориентированой системой, разработанной для использования на платформе LAMP (Linux+Apache+MySQL+PHP). Проект OrangeHRM активно развивается и довольно стабильно поддерживает процесс миграции на новые версии. Немаловажным фактором выбора этой платформы стал и тот факт, что этот проект имеет в Web широкое сообщество пользователей и разработчиков (адрес форума http://www.orangehrm.com/forum/), где очень хорошо организована обратная связь и есть возможность оперативно получать необходимую консультацию.
О популярности и распространенности этой системы свидетельствует тот факт, что начиная с даты выпуска первой бета-версии в январе 2006 года, на начало 2010 года (выход версии 2.5) было зарегистрировано больше 300 тысяч загрузок с сайта SourceForge. В декабре 2008 года проект был назван проектом месяца SourceForge.net. Система поддерживает большое количество языков, имеет видео материалы с инструкциями по установке и использованию, комплект учебных материалов. Установка системы очень проста и не нуждается в серьезных навыках по администрированию и работе с Web-серверами.
Платными для системы OrangeHRM являются плагины – аутентификации пользователей системы с помощью LDAP-сервера, экспорта отчетов для отслеживания событий, которые связаны с рабочим процессом.
Основные модули OrangeHRM: администрирования (Admin); управления персональной информацией (Personal Information Manager Module, PIM); персонализации работника (Employee Self Service Module, ESS); отчетов; отпусков (Leave Module); отслеживания за временем и посещением работников (Time and Attendance Module, Time); поощрений (Benefit Module); рекрутинга.
Модуль администрирования позволяет определять структуры организации, диапазоны оплаты, проекты, ведущиеся в организации.
Модуль управления персональной информацией поддерживает всю персональную информацию о сотрудниках – сведения о квалификации и опыту работы, фото, дополнительно прикрепляемые файлы документов.
Модуль персонализации работника позволяет сотрудникам самостоятельно вводить персональную информацию, такую, как контакты, образование, навыки, лицензии, осуществлять обновление личной информации с помощью Web-интерфейса, отправлять запрос на отпуск и редактировать личные расписания без непосредственного обращения к сотрудникам HR-отдела.
Модуль рекрутинга – набора персонала позволяет руководить в организации процессом подбора сотрудников. Менеджер по персоналу может создавать вакансии, которые состоят из перечня необходимых требований, названия подраздела и должности, и т.п.
Однако система OrangeHRM предоставляет только статические сведения и базовый функционал, который по обыкновению используется в обычных организациях. Отсутствие аналитики, возможности ведения и обработки специфической информации, учета компетенций, гибкости схемы базы данных и управление процессами побуждает к дополнению и дальнейшему развитию этой системы.
Для поддержки новых нужд, которые возникают перед менеджером по персоналу, предлагается систему ОrangeHRM дополнить новым функционалом, с использованием новых стандартов Semantic Web и результатов исследований в области управления человеческими ресурсами и психологии.

Begin 2 3 4 5

Область применения анализа компетенций

Использование методов онтологического анализа для управления компетенциями персонала как составной части планирования научных исследований (2)


Область применения анализа компетенций

В последнее время в результате комплексных исследований по психологии, менеджменту и теории обучения приобрели распространение новые теории управления персоналом – управление компетенциями (competence management) и управление талантами (talent management).
Управление компетенциями – новое направлением стратегического менеджмента, позволяющее организации развивать конкурентные преимущества в систематическом и структурном отношении. Впервые изучение компетенций для прогнозирования уровня эффективности выполнения работы было предложено американским психологом Д.МакКлелландом [1], который доказывал, что как традиционные тестирования способностей и знаний, так и наличие каких-либо дипломов у потенциальных исполнителей работы не обеспечивают им эффективного выполнения работ и успеха в профессиональной деятельности. Такие выводы привели Д. МакКлелланда к поиску тех характеристик, которые позволяют отличить конкретных исполнителей, способных выполнить определенные работы, – компетенций. Для этого он изучал характеристики успешных исполнителей работы и сравнивал их с характеристиками, которые демонстрируют менее успешные исполнители той же работы.
Р.Бояцис, исследовавший характеристики, которые связаны с эффективностью работы менеджеров независимо от специфики деятельности их организаций, установил, что компетенции необходимы для эффективного выполнения работы, но они не имеют решающего значения, если не соответствуют функциональным требованиям самой работы и культуре организации [2]. Именно это утверждение объясняет тот факт, что, зачастую, меняя место работы, а вместе с ним и условия организационного окружения, эффективные исполнители уже не достигают высоких результатов при выполнении аналогичной работы, а при изменении функциональных обязанностей работника в пределах той же организации (например, повышение в должности) исполнители, достигшие выдающейся эффективности в прошлом, не всегда обеспечивают ее на других должностях.
Управление талантами (термин введен Д.Уоткинсом в 1998 году) – процесс привлечения высококвалифицированных работников и повышения эффективности работы имеющихся для обеспечения максимальной прибыли. Важной частью этой концепции является обучение, как составляющая развития компетенций и способностей персонала, что в результате влияет на общий успех компании.
В [3] компетенции рассматриваются как базовые качества индивидуума, имеющие причинное отношение к эффективному выполнению роботы, а уровень этой эффективности определяется конкретными критериями. Среди таких базовых качеств они выделяют мотивы, психофизиологические характеристики и способности, самообраз человека, то есть его установки и ценности, а также знания, умения и навыки. Важно, что знания, умения и навыки Спенсеры относят к поверхностным компетенциям, которые достаточно просто развивать у исполнителей. В отличие от них, психофизиологические характеристики, способности и мотивы — это глубинные компетенции, которые очень сложно оцениваются и развиваются. Если же в основе компетенции лежит самообраз человека, то такую компетенцию можно развивать путем проведения тренингов, психокоррекции, упражнений для формирования позитивного отношения, хотя, безусловно, все это потребует значительных усилий и времени.


Рис.1. Уровни компетенций.
Управление компетенциями являются составляющей управления персоналом с точки зрения системного подхода наряду с функциями предприятия и корпоративной культурой.
Разработка профиля должности является нетривиальной задачей, сильно привязанной к ПрО. В настоящее время не существует общепринятых стандартов в подходах к содержанию и структуре Профиля должности, но они должны быть описаны в той степени подробности и содержать такую информацию, чтобы созданный профиль являлся эталоном должности и содержал все требования, соблюдение которых будет обеспечивать выполнение сотрудником всех своих обязанностей с требуемым качеством и в необходимые сроки. Профиль должен включать в себя следующую информацию:
• Место должности в общей организационной структуре предприятия.
• Функциональные обязанности должности.
• Профиль профессиональных компетенций.
• Личностный профиль.
• Формальные требования к сотруднику, выполняющему обязанности должности.
С одной стороны, только специалист в конкретной ПрО может оценить знания и навыки кандидата и его профессиональный уровень. Но если предпринимается попытка автоматизировать эту работу, то знания такого эксперта ложатся в основу онтологии ПрО и могут затем применяться без привлечени я самого эксперта. Это, во-первых, освобождает эксперта от рутинной работой и позволяет ему заниматься непосредственно своей работой, а во-вторых, обеспечивает некоторую объективность и позволяет интегрировать знания нескольких экспертов.
Профиль должности должен обеспечивать терминологическую базу и способы определения, в какой мере тому или иному кандидату присущи те или иные свойства, значимые в данной ПрО, а также методы и алгоритмы, позволяющие определить, в какой мере при определенном значении этих свойств кандидат будет способен выполнять выбранную задачу.
Модель компетенций дает возможность создать такой набор критериев, который непосредственно связывает широкий спектр конкретных видов деятельности с управлением персоналом. Набор общих критериев управления персоналом имеет два важных преимущества:
• возможность разработки общей терминологической базы (онтологии) для описания работы организации в целом, т.е обеспечение однозначной интерпретации организационной информации сотрудниками различных отделов и разных уровней организации (например, все научные сотрудники понимают, что квартальный отчет должен содержать более десяти, но менее ста страниц).
• возможность достижения высокого уровня согласованности при оценке работника.
Модель компетенций – термин для обозначения полного набора компетенций (с уровнями или без них) и индикаторов поведения. Модели могут содержать детальное описание стандартов поведения персонала конкретного отдела или стандарты действий, ведущих к достижению специальных целей, но могут и включать основные стандарты поведения, разработанные для полного описания деловой структуры или деятельности, направленной на достижение комплекса разнообразных корпоративных целей. Набор деталей, входящих в описание модели компетенции, зависит от предполагаемого практического применения конкретной модели.
Число компетенций в моделях последних лет уменьшилось. Когда-то были распространены модели, включавшие в себя 30 и более разных стандартов; сейчас обычны модели, содержащие не более 20 компетенций, а иногда - всего лишь восемь. Многие пользователи считают набор компетенций из 8-ми-12-ти стандартов в одной модели оптимальным. Вот один из подходов, включающий критические компетенции:
• Перечислить самые сложные «критические» рабочие задания данной должности.
• Перечислить компетенции, которые потребуются, чтобы выполнить каждое из этих заданий.
• Распределить эти компетенции в порядке важности для исполнения должностных обязанностей. Если модель включает уровни, распределите их по такому же принципу.
• Определить, смогут ли люди, обладающие конкретными компетенциями, быстро исполнять работу на приемлемом уровне качества. Если нет, то эти компетенции можно убрать из методологии отбора.
Оставшиеся компетенции и будут необходимыми для отбора кандидатов на вакантную должность.
Если все компетенции, включенные в модель, относятся ко всем видам деятельности компании или отдела, то такую модель часто называют «Основной моделью компетенций».
Основная модель не включает компетенции, устанавливающие различия в деятельности рабочих групп, для которых эта модель предназначена. Основная модель компетенций состоит из компетенций, которые охватывают стандарты поведения, общие для всех видов деятельности, или только стандарты для особых видов работы в конкретной организации. Стандарты поведения, включенные в основную модель, являются действительно общими, поэтому для приложения этих стандартов к конкретным видам деятельности нужно проделать дополнительную работу.
Компетенции содержат стандарты поведения, выявленные при наблюдении за эффективным выполнением работы внутри самой организации. Компетенции лучше всего оцениваются, если потенциальные работники наблюдаются при решении реальных задач в реальной обстановке.
Программное обеспечение оценки компетенций позволяет автоматизировать процедуры планирования, проведения и анализа результатов различных типов оценочных процедур, в том числе различные формы оценки по компетенциям. Стандартные задачи, обычно решаемые такими системами (рис.2): 1) Ведение библиотеки компетенций, знаний, навыков, поведенческих индикаторов; 2) формирование профилей должностей на основе библиотеки компетенций; 3) поддержка разных типов оценочных процедур и тестов.

Рис.2. Интерфейс ввода профиля кандидата в разделе компетенций.
Но обычно в таких системах нет динамической связи с внешними информационными ресурсами (ИР) и базами знаний (БЗ), нет своих механизмов логического вывода и самообучения. Все это в значительной мере снижает их эффективность и сужает область применения.
Такие критерии, как образование, квалификация и опыт, можно выявить уже в самом начале отбора. Компетенции проявятся позднее, уже в процессе отбора. Но компетенции способны внести важный вклад во все этапы отбора. Тем не менее такие исследования довольно эффективны лишь для довольно четко формализованных и описанных профессий и не пригодны для подбора и аттестации персонала, который занимается научными исследованиями. Это связано с тем, что, во-первых, для оценки работы научных работников нужно использовать знания о той предметной области, которую они исследуют. Эта Про постоянно меняется, дополняется и зачастую вообще может быть спорной с точки зрения разных теоретических концепций. Во-вторых, необходимо объективно оценивать результаты их работы, представленные в основном в виде естественноязыковых документов (статей, докладов, отчетов и т.п.). Кроме того, довольно часто важно оценить не общий научный потенциал конкретного лица, а целесообразность его участия в решении конкретной проблемы и сотрудничества в определенном коллективе. Все это приводит к необходимости использования в таких системах онтологии разного уровня (предметных областей, проблем, организационных и т.п.). Кроме того, возникает проблема интерпретации семантики научных работ (автоматизация семантической разметки ЕЯ-текста, создание и обработка их метаописаний, выбор способов их адекватного структурирования и хранения).
Одной из ключевых проблем вовлечения в бизнес-процессы компании значительных ресурсов неявных знаний, является проблема выявления профилей компетентности специалистов, их формализованного описания и формирования на этой основе соответствующей базы знаний.
Несмотря на то, что управление компетенциями является в настоящее время самостоятельной областью иссследований, с точки зрения информационных технологий системы управления компетенциями можно рассматривать и как частный случай системы управления знаниями (СУЗ), и как информационно-поисковую систему (ИПС), так как, несмотря на собственную специфику, эти системы решают задачу представления и сопоставления знаний о двух типах объектов – заданий и исполнителях, способных выполнить данные задания. Задача управления компетенциями представляется перспективной областью внедрения технологий Semantic Web. Причинами этого являются, с одной стороны, актуальность и комплексность самой задачи (и отсутствие ее автоматизированных решений для общих случаев), а с другой – необходимость использовать для решения такой задачи гетерогенные знания, распределенно представленные в Web. Мы рассматриваем частный случай этой задачи, связанный с управления компетенциями в сфере научных исследований. Эта подзадача представляется нам наиболее сложной и интересной по двум причинам, первая из которых – слабая формализованность профилей компетенций научных сотрудников (практически каждая отдельная научная тема требует разработки собственного профиля) и большое влияние специфики домена исследований, что предполагает необходимость автоматизированной обработки внешних баз знаний, содержащихся в Web. Вторая причина – деятельность научных сотрудников и результаты их работы обычно достаточно четко формализованы и открыты для анализа: это научные публикации, патенты, отчеты, описания разработок и прочие материалы, представленные в виде естественноязыковых (ЕЯ) текстов с элементами структурированных данных (таблиц и графиков) и мультимедиа, в большинстве случаев представленных в электронной форме, что допускает создание средств их автоматизированного анализа.

Begin 2 3 4 5

Использование методов онтологического анализа для управления компетенциями персонала как составной части планирования научных исследований

УДК 681.3: 519.68

Использование методов онтологического анализа для управления компетенциями персонала как составной части планирования научных исследований

Гришанова И.Ю., Рогушина Ю.В.,  к.ф.-м.н., доц., Інститут программных систем НАНУ, г. Киев

Предложены методы обработки онтологических знаний и их приложение в области управления компетенциями персонала как составной части планирования научных исследований. Предложено на основе имеющегося инструментария ПО по управлению персоналом расширить его функционал управления компетенциями путем интеграции средств управления знаниями –, онтологического анализа, элементов логического вывода, Web-сервисов  и мультиагентной парадигмы программирования.
Введение
Знания, интеллектуальный капитал, интеллектуальная собственность получают растущее признание в качестве нового источника прибыли организаций. В  частности, анализ управления компетенциями –  знаниями о способности персонала эффективно выполнять различные виды работ – является важной и перспективной задачей, для решения которой разработаны разнообразные модели и методики. Создано много методов, эвристик и программных средств, которые автоматизируют работу экспертов в этой сфере.

Wednesday, May 19, 2010

Использование методов онтологического анализа для управления компетенциями

Использование методов онтологического анализа для управления компетенциями персонала как составной части планирования научных исследований

Рогушина Ю.В., Гришанова И.Ю., ИПС НАНУ

Ключевые слова: онтологический анализ, управление компетенциями, Semantic Web
ИАИ2010

Презентация


Рогушина Юля  делает свою часть доклада.

Популярное

Использование материалов сайта

Информация, представленная на сайте, может свободно использоваться и распространяться при обязательном указании активной прямой ссылки на сайт http://in-search-of-semantics.blogspot.com/, а тексты научных статей – при указании авторства и ссылки на бумажную публикацию.

При размещении текстов статей на своих сайтах, блогах и пр., пожалуйста, присылайте ссылки.
Комментарии перед публикацией предварительно модерируются.

Хотите сказать спасибо автору? Не откажусь :) - Поставьте ретвит на пост, или другую социальную закладку. Спасибо.